De ce buclele agentului epuizează bugetul?
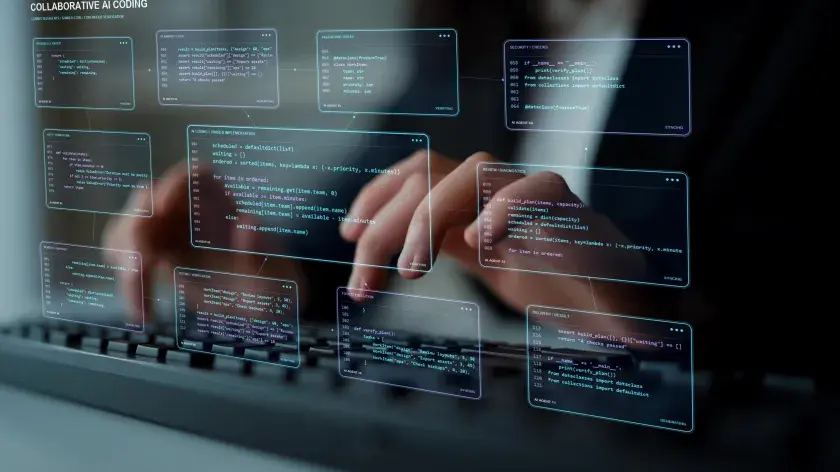
Trecerea de la prompturi simple la agenți autonomi a schimbat complet modul în care echipele măsoară utilizarea AI. O singură sarcină de codare declanșează planificare, generare de cod, testare și bucle de corectare a erorilor.
Culture picks
 Cum IA-ul personalizat redorește echilibrul emoțional al utilizatorilor
 Costurile Grok sunt nesustenabile față de venituri
 OpenAI va uni tab-urile Chat și Work în aplicația desktop
 Stocare pe Nintendo Switch 2: de ce cardul potrivit contează
Fiecare buclă consumă tokeni suplimentari.
Când un agent AI preia o sarcină de codare, nu se oprește după prima răspuns. El planifică abordarea, generează cod, rulează teste și iterează pentru a corecta erorile.
Cum ar trebui să se reîndrumă echipele?
Acest proces multi-pas multiplică dramatic consumul de tokeni. HPE subliniază că cu cât agentul e mai capabil, cu atât face mai multe apeluri API. Prețul pe token înseamnă că dezvoltatorii plătesc pentru fiecare apel, ceea ce face fluxurile de lucru complexe scumpe.
Articolul susține că numărarea tokenilor nu e mai departe metrica corectă. Echipele ar trebui să numere ce ajunge efectiv, nu numărul de tokeni consumați.
Această schimbare de focus ajută la alinierea cheltuielilor cu livrările reale.
Dezvoltatorii care folosesc agenți AI pentru codare se confruntă cu o realitate nouă a costurilor. Pe măsură ce agenții devin mai autonomi, consumul de tokeni crește odată cu capacitatea.
Întrebări frecvente?
HPE recomandă organizațiilor să înceteze urmărirea numărului brut de tokeni și să înceapă măsurarea lucrului finalizat. Această abordare ține cheltuielile AI legate de valoarea livrată, nu de overhead-ul computațional.
Câți de mai mulți tokeni consumă un agent față de un prompt simplu? Un agent AI de codare consumă de 10 la 50 ori mai mulți tokeni decât un prompt de chat simplu. Acest multiplicator vine din ciclurile iterațive de planificare, testare și corectare a erorilor ale agentului.
Ce recomandă HPE să urmărească echipele în loc de tokeni? HPE recomandă echipele să urmărească ce ajunge, adică funcționalitățile finalizate și lucrul livrat. Această metrică aliniază costurile AI cu câștigurile reale de productivitate.