Care a fost timpul de antrenament pentru fiecare metodă?
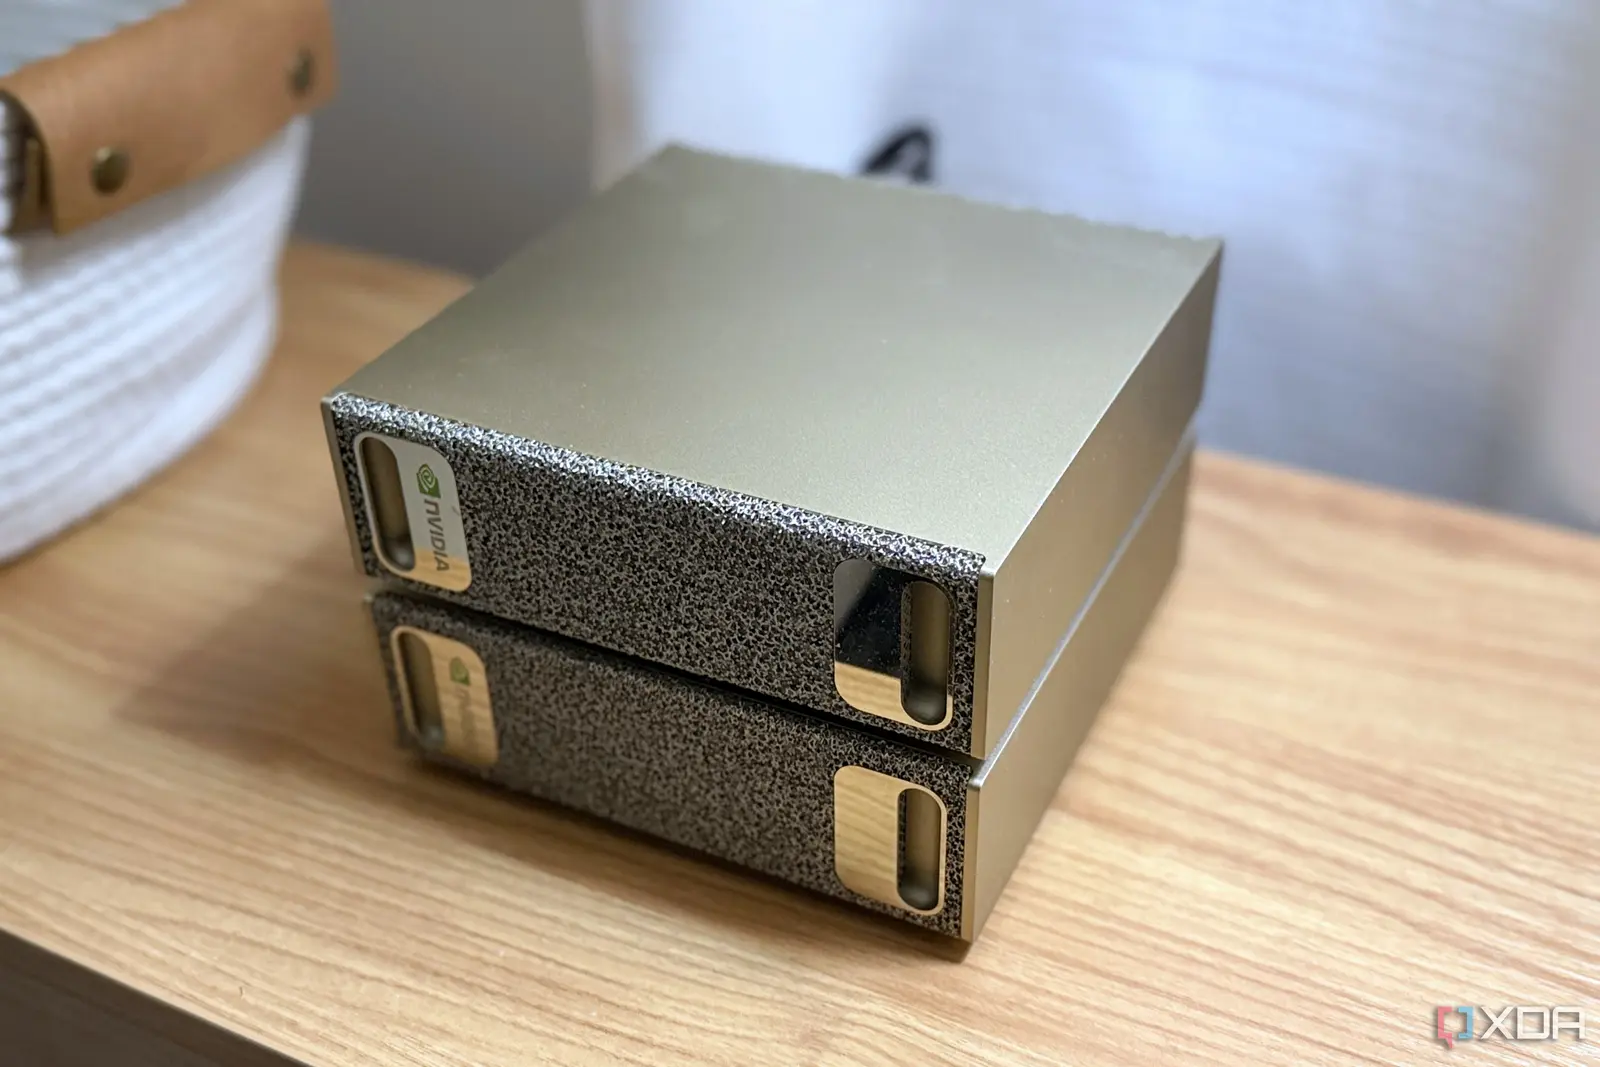
În octombrie 2026, un pasionat de tehnologie a testat trei abordări pentru a adapta ChatGPT pe un cluster Nvidia DGX Sparks, descoperind că doar una dintre ele a adus un impuls semnificativ de viteză.
Culture picks
 Controlul cruzei adaptiv: tehnologia simplă ce schimbă drumul
 Google DevSite: Vulnerabilitate RCE prin cookie‑uri Flask
 Viitorul telefoanelor flagship: Răcirea activă devine noua normă?
 VoicePatrol atrage 3,4 milioane de dolari pentru a schimba moderarea vocală în jocuri
Experimentul a fost realizat de un singur dezvoltator, cu experiență în modele AI pe cloud, care a configurat sistemul Nvidia DGX Sparks, echipat cu 16 GPU A100, pentru a antrena o variantă a arhitecturii ChatGPT. Scopul a fost să scadă timpii de Prima abordare a folosit Trainerul standard de la Hugging Face, cu hiperparametri implicit. Antrenamentul a durat aproximativ 48 de ore, iar latenta inferenței nu s-a schimbat față de setul de bază.
A doua metodă a aplicat un schemă de antrenament cu precizie mixtă, combinând formatele FP16 și BF16.
Deși timpul de antrenament a scăzut cu 20%, viteza inferenței nu a crescut semnificativ.
În cea de-a treia și finală tehnică, a fost introdusă o strategie de sharding personalizată care a distribuit greutățile modelului pe GPU-uri mai eficient. Această configurație a redus latenta inferenței cu 35% și a diminuat utilizarea memoriei GPU, permițând rularea modelului pe mai puține dispozitive fără a compromite calitatea.
Sharding-ul a afectat acuratețea modelului?
Abordarea de sharding a folosit cadrul Megatron‑LM de la Nvidia, care împarte atât modelul, cât și stările optimizatorului. Aliniind partajele de greutăți cu topologia GPU-ului, pipeline-ul a minimizat comunicarea între GPU-uri.
Dezvoltatorul a observat: „Cheia a fost să reducem suprasarcina de mișcare a datelor care încetinește inferența la scară largă.” Modelul rezultat a obținut o rată de 30 de tokeni pe secundă, comparativ cu 20 de tokeni pe secundă în configurația implicită.
De ce a performat sharding-ul mai bine? Conform experimentului, blocajul în celelalte pipeline-uri era operațiunile all‑reduce care sincronizează gradientele între GPU-uri. Noua schemă de partajare a înlocuit aceste operațiuni cu transferuri punct‑la‑punct, mai rapide pe arhitectura DGX Sparks. În plus, optimizatorul personalizat a redus fragmentarea memoriei, permițând GPU-urilor să proceseze batch-uri mai mari în timpul inferenței.
Ce înseamnă asta pentru dezvoltatorii de AI conversațional? Rezultatele sugerează că investiția în partajare personalizată a modelului poate aduce beneficii semnificative de performanță pe hardware Nvidia.
Poate fi folosit sharding pe alte platforme GPU?
Totuși, complexitatea implementării poate descuraja echipele mici. Dezvoltatorul a subliniat: „În ciuda curbii de învățare abrupte, câștigurile în viteză și economiile de cost sunt semnificative pentru sarcini de producție.”
În viitor, se va explora combinarea tehnicii de sharding cu cuantizarea pentru a reduce și mai mult latenta. Există, de asemenea, interes pentru automatizarea procesului de partajare, astfel încât să poată fi aplicat altor modele transformer fără reglaje manuale.
Trainerul standard a durat aproximativ 48 de ore, versiunea cu precizie mixtă a scăzut la 38 de ore, iar abordarea cu sharding personalizat a finalizat în 32 de ore.
Nu, acuratețea a rămas în intervalul de 0,5% față de setul de bază, indicând că câștigurile de viteză nu au compromis performanța.
Da, dar necesită suport pentru layout-ul specific de memorie și primitivele de comunicare utilizate de Megatron‑LM de la Nvidia.